소식

  • 예지보전 AI, 설비 고장 미리 잡아내는 원리와 도입법

    예지보전 AI, 설비 고장 미리 잡아내는 원리와 도입법

    터빈 하나가 예고 없이 서버린다. 그 순간 발전소는 시간당 수천만 원을 그냥 날린다. 항공기 엔진이 비행 중에 이상을 일으키면? 그건 돈으로 따질 문제가 아니다. 그래서 발전, 항공, 중공업 쪽은 오래전부터 설비가 망가지기 전에 미리 알아채는 기술에 돈을 쏟아부어 왔다. 요즘은 여기에 AI가 빠지지 않는다. 흔히 예지보전(Predictive Maintenance)이라 부르는 이 기술, 실제로 어떻게 돌아가고 도입하려면 뭐가 필요한지 정리해봤다.

    예지보전이란 정확히 뭔가

    한마디로, 센서 데이터를 뜯어보고 고장 시점을 미리 짚어내는 정비 방식이다. 진동, 온도, 압력, 전류. 이런 값들을 실시간으로 모으고, 정상 범위를 벗어나는 패턴을 AI 모델이 잡아낸다. 사람 눈으로는 절대 못 잡는 미세한 변화까지 걸러낸다는 게 강점이다.

    사후정비·예방정비랑 뭐가 다른가

    정비 방식은 크게 셋으로 나뉜다.

    • 사후정비(Reactive): 고장 나면 그때 고친다. 비용은 제일 싸다. 대신 가동이 멈추는 리스크는 고스란히 떠안는다.
    • 예방정비(Preventive): 정해둔 주기마다 부품을 바꾼다. 문제는 멀쩡한 부품도 시간 됐다고 갈아치우니 낭비가 생긴다는 점.
    • 예지보전(Predictive): 실제 설비 상태를 보고 정비 시점을 정한다. 불필요한 교체는 줄이고, 고장 직전에 딱 맞춰 손을 본다.

    비용과 가동률, 두 마리 토끼를 동시에 잡을 수 있는 이유가 여기 있다.

    AI가 고장을 미리 잡아내는 원리

    기본은 이상탐지(Anomaly Detection)다. 정상 가동일 때의 센서 데이터를 학습시켜 ‘평소 패턴’을 모델에 박아 넣는다. 그다음 실시간 데이터가 이 패턴에서 얼마나 벗어나는지 점수를 매긴다. 여기에 시계열 예측까지 얹으면 ‘이상하다’ 수준을 넘어선다. ‘앞으로 며칠 안에 고장 확률 몇 퍼센트’까지 뽑아낸다는 얘기다. 진동 데이터는 주파수 분석으로, 온도·압력은 여러 변수를 한꺼번에 보는 다변량 분석으로. 설비 종류마다 쓰는 기법이 달라진다.

    도입하려면 뭐부터 갖춰야 하나

    솔직히 기술보다 데이터 인프라가 먼저다.

    • 센서: 진동, 온도, 전류 등을 상시 재는 하드웨어
    • 데이터 수집·저장 체계: 현장 데이터를 끊김 없이 모을 통신망과 저장소
    • 레이블링된 고장 이력: 과거 어떤 패턴이 실제 고장으로 이어졌는지 기록해둔 것
    • 도메인 전문가: 모델이 잡아낸 신호가 진짜 의미 있는지 걸러줄 사람

    이 중 하나라도 빠지면 모델 성능은 뚝 떨어진다. 신규 설비처럼 고장 이력이 부족하면? 처음엔 규칙 기반 임계값으로 버티다가 데이터가 쌓이는 대로 모델을 고도화하는 편이 현실적이다.

    실제로 어디서 쓰고 있나

    에너지 업계는 풍력·화력 터빈의 베어링 마모를 예측해서 정지 시간을 줄이는 데 AI를 쓴다. 제조업은 컨베이어 벨트, 모터, 압축기 같은 핵심 설비에 센서를 붙여 라인이 서는 걸 막는다. 항공사는 엔진 센서 데이터를 실시간으로 뜯어보며 정비 스케줄을 짠다. 공통점 하나. 설비 하나가 멈췄을 때 손실 규모가 크고, 정비를 사람 감이 아니라 데이터로 대체하려는 목적이 뚜렷하다.

    도입 전에 따져봐야 할 것들

    모든 설비에 예지보전이 남는 장사는 아니다. 설비 가격이 낮고 대체하기 쉬우면 오히려 사후정비가 싸게 먹힌다. 반대로 가동 중단 손실이 크거나 안전 문제로 번지는 설비라면, 초기 투자는 감수할 가치가 있다. 이건 좀 놓치기 쉬운 부분인데, 데이터 보안도 짚고 넘어가야 한다. 산업 제어망(OT)에 센서와 클라우드를 연결하면 그만큼 공격 표면이 새로 생긴다. 망 분리와 접근 통제, 이 두 가지는 함께 설계해야 뒤탈이 없다.

    결국 살아남는 건 우선순위를 정한 곳

    핵심은 간단하다. 어떤 설비에, 어느 수준의 데이터로, 어떤 정비 방식을 적용할지 설비별로 나눠보는 작업. 모든 곳에 똑같은 수준의 AI를 붙이는 대신 손실 규모와 데이터 확보 가능성을 기준 삼아 우선순위를 매기는 편이 실무적으로 낫다.
    출처: MIT Tech Review AI

  • 그릴 사야 할까 그리들 사야 할까, 차이부터 뜯어보자

    그릴 사야 할까 그리들 사야 할까, 차이부터 뜯어보자

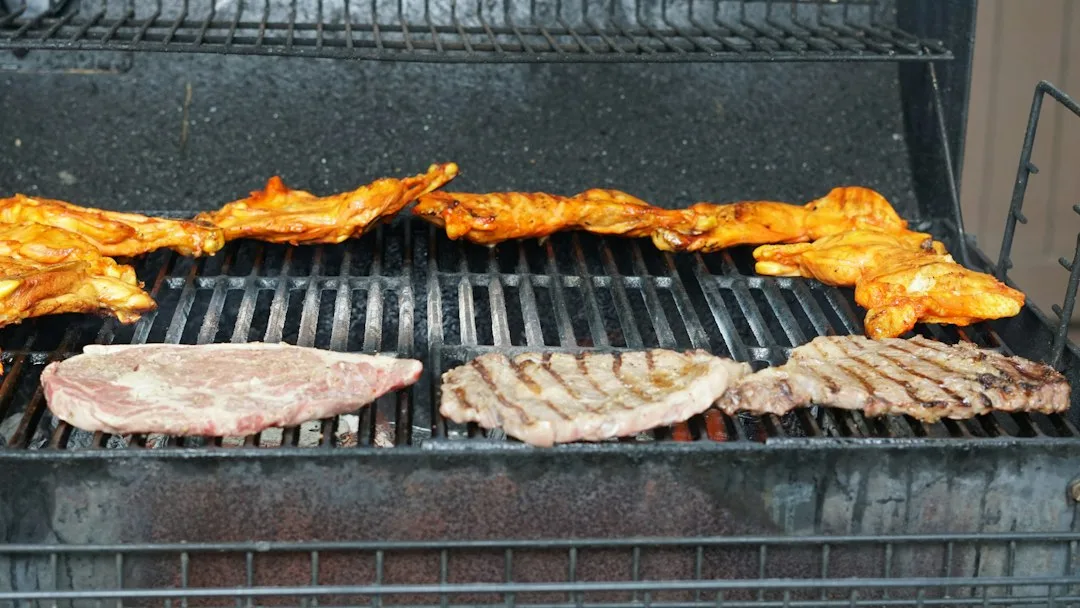
    친구네 집들이에 갔더니 마당에서 지글지글 소리가 났다. 불판인가 싶어 다가갔는데, 웬걸. 격자무늬 석쇠가 아니라 넓적한 철판 위에서 고기랑 채소가 같이 구워지고 있었다. ‘이거 그릴 아니고 그리들이야.’ 친구 말에 그제야 알았다. 그릴이랑 그리들이 다른 물건이라는 걸. 나만 몰랐나 싶었는데 물어보니 의외로 이 둘 구분 못 하는 사람이 많더라. 야외 조리 장비를 처음 장만하는 거라면 이 차이부터 정확히 알아두는 게 돈 아끼는 지름길이다.

    그릴이랑 그리들, 구조부터 다르다

    그릴은 석쇠나 격자 모양 팬에 재료를 얹어 굽는 방식이다. 열이 아래에서 직접 올라오다 보니 특유의 그릴 마크와 훈연 향이 배어든다. 그리들은 다르다. 매끈한 철판 하나가 전부라서 재료가 불에 직접 닿지 않는다. 팬케이크, 계란 요리, 볶음밥처럼 국물이나 기름이 흘러나오면 곤란한 요리엔 이쪽이 유리하다.

    열전달 방식 하나로 요리 맛이 갈린다

    그릴은 국소적으로 열이 확 오르는 구조라 겉은 바삭하고 속은 촉촉한 스테이크, 삼겹살 같은 메뉴에 잘 맞는다. 다만 불판 틈으로 기름이 떨어지면서 연기와 불꽃이 자주 튄다. 온도 조절에 손이 좀 간다는 뜻이다. 그리들은 철판 전체가 고르게 달궈진다. 온도 편차가 적고, 재료 여러 개를 한꺼번에 올려도 익는 속도가 비슷하게 맞아떨어진다. 처음 다뤄보는 사람이라면 그리들 쪽이 실수할 확률이 낮다.

    어떤 음식엔 뭐가 맞을까

    고기 본연의 육즙과 훈연 향을 살리고 싶으면 답은 그릴이다. 스테이크, 폭립, 통닭구이처럼 두툼한 덩어리 요리는 특히 그릴의 강한 직화가 유리하다.

    • 아침 브런치나 팬케이크, 베이컨, 계란 프라이 – 그리들
    • 해산물, 새우, 채소볶음처럼 부서지기 쉬운 재료 – 그리들
    • 스테이크, 삼겹살, 갈비 같은 두꺼운 고기 – 그릴
    • 여러 명이 각자 다른 메뉴를 동시에 – 그리들

    홈파티를 자주 여는 편이면 철판 하나로 고기, 볶음밥, 계란까지 순서대로 처리할 수 있는 그리들이 활용도 면에서 낫다는 얘기를 자주 듣는다.

    청소는 어느 쪽이 더 손이 갈까

    그릴은 격자 틈새에 탄 기름때랑 재가 끼기 쉬워서 전용 브러시로 매번 긁어내야 한다. 방치하면 녹슬거나, 다음 조리 때 탄내가 배는 일도 흔하다. 그리들은 표면이 평평하니 스크래퍼로 한 번 밀면 대부분 정리가 끝난다. 시즈닝, 그러니까 기름 코팅 관리만 꾸준히 해주면 오래 써도 상태가 크게 나빠지지 않는다. 청소 부담 줄이고 싶다면 그리들 쪽이 확실히 편하다.

    가격표부터 비교해보면

    보급형 가스 그릴은 20만 원대부터 시작한다. 훈연 기능을 얹은 스모커형은 백만 원을 훌쩍 넘기도 한다. 그리들은 화력 구성에 따라 가격 폭이 넓은데, 국내에서 쉽게 구할 수 있는 2버너 이상 모델은 30만~80만 원대가 주력이다. 여기에 커버, 오일 디스펜서, 스크래퍼 같은 액세서리 비용까지 더해야 실제 지출이 나온다. 여름 성수기나 명절 시즌엔 브랜드사에서 할인 행사를 여는 경우가 잦다. 구매 시점을 조금만 늦춰도 같은 모델을 더 싸게 살 여지가 있다는 얘기다.

    처음이라면 이 순서를 권한다

    야외 조리를 처음 시작한다면 소형 그리들 하나로 시작해보길 권한다. 실패 확률이 낮고 관리도 쉬워서 부담이 적다. 고기 굽는 재미를 제대로 느끼고 싶어지면, 그때 그릴을 추가로 들이는 순서가 합리적이다. 반대로 캠핑이나 백패킹처럼 이동이 잦은 용도라면 부피 작고 조립 간단한 미니 그릴이 그리들보다 실용적이다. 결국 본인이 자주 만드는 메뉴랑 사용 장소부터 정하고, 그다음에 장비를 고르는 순서가 맞다.

    액세서리 하나로 완성도가 달라진다

    그릴이든 그리들이든 온도계, 방수 커버, 전용 오일만 갖춰도 사용 경험이 확 달라진다. 그리들은 시즈닝용 오일과 스크래퍼가 세트처럼 붙어 다니는데, 처음 살 때 번들 구성으로 사면 낱개로 사는 것보다 지출이 줄어든다. 그릴은 훈연칩이나 드립팬을 추가하면 바비큐 전문점 못지않은 향을 낼 수 있다. 장비값 못지않게 소모품 투자도 챙겨볼 만하다.

    출처: The Verge

  • 엔비디아 독주 막을까, AI 반도체 스타트업 톱5 뜯어봤다

    엔비디아 독주 막을까, AI 반도체 스타트업 톱5 뜯어봤다

    엔비디아가 데이터센터용 GPU 시장을 사실상 싹쓸이하는 동안, 그 자리를 노리는 스타트업들에 실리콘밸리 투자금이 꾸준히 몰리고 있다. 이 회사들 대부분은 상장 전이라 개인이 접근하기 힘들고 이름조차 낯설다. 그래서 정리해봤다. 업계에서 실제로 거론되는 AI 반도체 스타트업 5곳, 각자 노리는 시장, 엔비디아와 다른 점을 최대한 실무적으로 풀었다.

    GPU 하나로는 부족한 이유

    GPU는 원래 그래픽 연산용 범용 병렬 프로세서다. AI 학습과 추론에 강하긴 한데, 범용이라는 게 발목을 잡는다. 특정 연산 하나에만 회로를 몰아준 전용 칩(ASIC)보다 전력 효율이 떨어질 수밖에 없다는 얘기다. 데이터센터 전기료가 손익을 좌우하는 시대다. 트랜스포머 연산 하나만 파고든 칩이 같은 작업을 훨씬 적은 전력으로 처리한다면, 대형 클라우드 업체 입장에선 갈아탈 이유가 생긴다. 지금 도전자들이 노리는 틈이 바로 여기다.

    Etched — 트랜스포머 전용 칩 ‘소하(Sohu)’

    Etched는 GPU의 범용 회로를 걷어내고 트랜스포머 아키텍처 연산만 처리하는 칩 ‘소하’를 만들고 있다. 회로를 특정 연산에만 맞췄더니, 같은 트랜스포머 기반 모델을 돌릴 때 엔비디아 최상급 GPU보다 처리량이 수 배 높다는 자체 벤치마크를 내놨다. 단점도 뚜렷하다. 트랜스포머가 아닌 다른 구조의 모델이 대세가 되면 이 칩은 그대로 무용지물이다. 구조 자체가 베팅이다. 그런데도 최근 시리즈 투자에서 조 단위 기업가치를 인정받으며 투자 시장의 뜨거운 화두로 떠올랐다.

    Groq — 추론 속도에 올인한 LPU

    Groq는 학습이 아니라 추론(inference) 속도에 몰빵했다. LPU(Language Processing Unit)라는 이름부터가 그 증거다. 챗봇처럼 사용자가 답변을 실시간으로 받아야 하는 서비스에서 응답 지연이 눈에 띄게 줄어드는 게 강점이다. 실제로 자사 데모 사이트에 들어가 보면, 대형 언어모델이 사람이 텍스트를 읽는 속도보다 빠르게 답을 뽑아내는 걸 확인할 수 있다. 다만 메모리 용량 한계가 발목을 잡는다. 초대형 모델 하나를 통째로 올리려면 칩을 대량으로 묶어야 하는데, 이게 곧 비용 문제로 돌아온다.

    Cerebras — 웨이퍼 한 장이 칩 하나

    Cerebras의 접근법은 반도체 업계 상식을 뒤집는다. 보통 웨이퍼 한 장에서 칩을 수백 개씩 잘라내는데, 이 회사는 웨이퍼 한 장 전체를 칩 하나로 쓴다. 웨이퍼 스케일 엔진이다. 칩 간 통신 병목이 사라지니 초거대 모델 학습에서 속도 이점이 크다. 실제로 일부 국가 연구기관과 제약사가 슈퍼컴퓨터 대체용으로 도입한 사례도 있다. 관건은 제조 수율과 단가다. 대량 보급까지는 아직 시간이 더 필요하다는 평가가 나온다.

    SambaNova — 기업 내부망 특화

    SambaNova는 클라우드가 아니라 기업 내부 데이터센터에 시스템을 통째로 납품하는 쪽에 무게를 둔다. 금융, 정부기관처럼 데이터를 외부로 내보낼 수 없는 조직이 주 고객이다. 소프트웨어 스택까지 하드웨어와 묶어 패키지로 제공해 도입 문턱을 낮췄다. 벤치마크 경쟁보다는 규제 산업이라는 확실한 틈새를 파고드는 전략, 이게 이 회사의 승부수다.

    Tenstorrent — 개방형 생태계로 승부

    반도체 전설로 불리는 짐 켈러가 이끄는 Tenstorrent는 폐쇄적인 소프트웨어 스택 대신 오픈소스 툴체인을 밀고 있다. 엔비디아의 CUDA 종속에서 벗어나고 싶어하는 개발자와 기업이 늘어나는 흐름을 정면으로 겨냥한 셈이다. 대형 클라우드 채택 사례는 아직 제한적이다. 다만 라이선싱 모델을 통해 다른 반도체 회사에 설계 자산을 넘기는 방식으로도 수익을 낸다. 이건 좀 우회적인 전략인데, 의외로 통할 수도 있다.

    돈은 왜 이쪽으로 몰리나

    이런 회사들 상당수는 아직 비상장이라 개인이 주식을 사기 쉽지 않다. 그런데도 벤처캐피털은 물론 개인 투자자들까지 지분을 확보하려고 여러 경로를 찾는다. 초기 라운드에 참여한 펀드의 지분을 세컨더리 마켓에서 되사거나, SPV(특수목적법인)를 통해 소액으로 묶어 투자하는 방식이 대표적이다. 이런 구조는 창업 초기 인맥이나 지역 네트워크로 배정 물량을 확보한 소수 투자자에게 유리하게 돌아가는 경우가 많다. 정작 정보가 늦은 개인 투자자는 뒤늦게 프리미엄을 얹어 지분을 사게 되는 구조적 한계가 있다. 이건 솔직히 좀 불공평하다.

    결국 지켜봐야 할 곳은 이 2곳

    단기간에 엔비디아 점유율을 크게 뺏을 곳을 하나만 꼽으라면 무리다. 응용 분야별로 나눠 보면 답이 갈린다. 실시간 응답이 핵심인 서비스라면 Groq의 추론 속도, 트랜스포머 구조에 베팅한 초고속 처리라면 Etched의 소하 칩이 가장 먼저 언급된다. 나머지 세 곳은 특정 산업이나 개발자 생태계라는 좁지만 확실한 시장을 노린다. 성장 속도는 느려도 생존 가능성은 오히려 안정적이라는 시각도 있다.

    Q&A — 이것도 궁금하죠?

    Q. 이런 스타트업에 개인도 투자 가능한가?
    대부분 비상장이라 직접 주식을 사기는 어렵다. 다만 일부 크라우드펀딩 플랫폼이나 세컨더리 마켓을 통해 제한적으로 접근하는 경로가 있다.

    Q. Etched의 소하 칩은 언제 실제 제품으로 나오나?
    회사 측은 출시 로드맵을 공개했다. 다만 반도체는 설계부터 양산까지 보통 2~3년이 걸리는 산업이다. 발표 시점과 실제 서비스 적용 시점 사이에는 간극이 생기기 마련이다.

    Q. 이 회사들이 엔비디아를 실제로 위협할 수 있나?
    전체 시장 점유율을 뒤집기보다는 특정 응용 분야에서 점유율을 조금씩 잠식하는 형태가 될 가능성이 크다. 엔비디아도 소프트웨어 생태계라는 강력한 해자를 갖고 있어 단기간에 판이 뒤집히긴 어렵다.

    출처: TechCrunch

  • AI 업무 자동화, 어디서부터 손대야 할까 (실전 가이드)

    AI 업무 자동화, 어디서부터 손대야 할까 (실전 가이드)

    회사 업무에 AI를 붙이자는 말, 요즘 안 들리는 데가 없다. 그런데 정작 “AI로 업무 자동화 하자”는 회의에 들어가 보면 다들 딴 얘기를 한다. 누구는 RPA, 누구는 챗봇, 누구는 생성형 AI 에이전트. 셋이 다 다른 건데 한 단어로 뭉뚱그려 쓴다. 린 식스시그마와 BPM(비즈니스 프로세스 관리)이 수십 년간 붙잡고 있던 문제를 이제 AI가 거들겠다는 얘기인데, 정확히 뭐가 달라지고 뭐부터 손대야 하는지 실무 기준으로 정리해봤다.

    린 식스시그마·BPM이랑 AI 자동화, 뭐가 다른가

    린 식스시그마는 통계로 품질을 관리하는 방법론이고, BPM은 부서를 넘나드는 업무 흐름을 지도로 그려 표준화하는 쪽이다. 둘 다 사람이 프로세스를 뜯어보고 규칙을 짠 다음, 그 규칙대로 사람이나 시스템을 움직이게 하는 구조는 같다. AI가 끼어드는 지점은 딱 두 곳이다. 첫째, 프로세스 안에 숨은 병목을 데이터로 찾아내는 분석 단계. 둘째, 정형화하기 힘들었던 예외 처리나 판단 업무를 대신 처리하는 실행 단계다. 기존 BPM이 “이 조건이면 이 부서로 넘긴다”는 식의 규칙 기반이었다면, AI 자동화는 규칙으로 못 만들던 애매한 케이스까지 손을 댈 여지가 생겼다는 점에서 무게가 다르다.

    RPA랑 AI 에이전트, 자꾸 헷갈리는 이유

    둘을 같은 걸로 착각하는 사람 많다. 동작 방식부터 다른데.

    • RPA(로보틱 프로세스 자동화): 정해진 화면 클릭, 데이터 입력, 파일 이동 같은 반복 작업을 그대로 흉내낸다. 규칙이 바뀌면 스크립트도 처음부터 다시 짜야 한다.
    • AI 에이전트: 목표만 던져주면 상황 봐가며 판단하고 여러 도구를 엮어서 일을 끝낸다. 문서 형식이 살짝 달라져도 그럭저럭 맞춰간다.
    • 하이브리드형: 반복 구간은 RPA로, 판단이 필요한 구간은 AI 에이전트로 넘기는 방식. 요즘 기업 도입 사례에서 부쩍 늘었다.

    단순 반복 업무뿐이라면 RPA로 충분하다. 문서 해석이나 고객 응대처럼 맥락을 읽어야 하는 업무라면 얘기가 다르다. AI 에이전트 쪽으로 가는 게 맞다.

    도입 순서, 이 4단계는 건너뛰지 말 것

    순서 안 지키고 툴부터 사는 게 실패로 가는 지름길이다.

    • 1단계: 지금 돌아가는 프로세스를 있는 그대로 지도로 그린다. 이거 생략하고 자동화부터 하면 비효율까지 그대로 자동화해버린다.
    • 2단계: 반복 빈도 높고 규칙 명확한 구간부터 골라낸다.
    • 3단계: 작은 범위에서 파일럿을 돌리고 처리 시간, 오류율을 잰다.
    • 4단계: 파일럿 숫자를 근거로 전사 확대할지 결정한다.

    처음부터 회사 전체에 밀어붙이면 실패했을 때 되돌리기가 만만찮다. 작은 단위로 시작해서 숫자로 검증하는 쪽이 결국 실패 비용을 줄인다.

    도입 전에 걸러야 할 함정들

    실제 도입 실패 사례를 보면 반복되는 패턴이 있다.

    • 데이터 품질을 안 보고 시작: 프로세스 데이터가 지저분하면 AI가 엉뚱한 패턴을 학습한다.
    • 현업 담당자를 빼고 설계: 실제로 그 일을 하는 사람이 빠지면 현실과 동떨어진 결과물이 나온다.
    • ROI 기준이 아예 없음: 처리 시간 단축, 오류 감소 같은 구체적 숫자 없이 시작하면 나중에 성과를 증명할 방법이 없다.
    • 보안·권한 설계를 빼먹음: AI 에이전트가 여러 시스템을 넘나드는 만큼 접근 권한부터 세밀하게 나눠야 한다.

    그래서 뭐부터? 우선순위 정리

    업무 전체를 한 번에 바꾸려 들지 말고 순서대로 접근하는 편이 안전하다.

    • 1순위: 데이터 입력·집계처럼 규칙이 명확하고 실수해도 리스크 낮은 업무
    • 2순위: 문서 분류, 1차 고객 문의 응대처럼 패턴은 있는데 예외가 섞인 업무
    • 3순위: 계약서 검토, 재무 이상 탐지처럼 판단 비중 크고 리스크도 큰 업무

    3순위 업무는 AI가 초안이나 후보를 뽑아주고 최종 결정은 사람이 하는 구조로 짜는 게 지금으로선 현실적이다. 여기서 사람 손을 놓으면, 솔직히 사고 난다.

    핵심만 3줄로 정리하면

    프로세스 지도부터 그리기. 작은 단위 파일럿으로 검증하기. 리스크 낮은 업무부터 순서대로 넓히기. 툴을 뭘 쓰느냐보다 이 순서를 지키느냐가 성패를 가른다. 린 식스시그마와 BPM이 오랫동안 다져온 프로세스 분석 방법론 위에, AI라는 실행 엔진 하나 얹는다고 생각하면 접근이 한결 쉬워진다.

    출처: MIT Tech Review AI

  • 우주선 부품은 어디로 사라지나 — 화성 착륙선 로봇팔이 50년째 실종 중

    우주선 부품은 어디로 사라지나 — 화성 착륙선 로봇팔이 50년째 실종 중

    1976년 여름, 바이킹 1호가 화성 표면에 내려앉았다. 로봇팔로 흙을 퍼 담았고, 이 설계는 이후 모든 화성 탐사선 샘플러의 원형이 됐다. 그런데 당시 지상 시험에 쓰였던 실물 팔 하나, 지금 어디 있는지 아무도 모른다. 50년째다. Ars Technica 보도에 의하면 NASA 아카이브 어디를 뒤져도 이 부품이 마지막으로 어디로 갔는지 기록이 없다고 한다. 우주 하드웨어 한 점이 이렇게 통째로 증발할 수 있다니, 우주 탐사사에 관심 있는 사람이라면 궁금하지 않을 수 없는 얘기다.

    부품은 왜 흔적도 없이 사라지나

    이유는 의외로 단순하다. 발사체나 착륙선 자체는 국가 자산으로 빡빡하게 관리된다. 반면 지상에서만 쓰인 시험용 장비나 예비 부품은 취급 기준이 헐겁다. 프로젝트가 끝나면 담당 부서가 해체되고, 창고를 옮기거나 기관이 통폐합되는 와중에 목록조차 남기지 않은 채 폐기되거나 다른 손으로 넘어간다. 1970~80년대엔 디지털 자산관리 시스템이란 게 아예 없었다. 종이 문서와 사람 기억에 의존했던 시절이라, 담당자가 은퇴하거나 세상을 뜨면 그 부품의 이력도 같이 끊긴다.

    엔지니어링 모델과 플라이트 모델, 뭐가 다른가

    이 이야기를 제대로 이해하려면 우주 하드웨어 등급부터 짚고 가야 한다.

    • 플라이트 모델(Flight Model) — 실제로 우주로 올라가는 진짜 기체. 발사 후엔 대부분 지구로 돌아오지 않는다.
    • 엔지니어링 모델(Engineering Model) — 지상에서 기능을 검증하려고 만든 실물 크기 시험 장비. 비행은 안 하지만 설계 검증, 고장 대응 훈련, 언론 시연용으로 두고두고 쓰인다.
    • 예비품(Spare/Backup) — 발사 직전까지 대기하다가, 임무에 문제가 생기면 바로 투입할 수 있게 준비해 둔 여분 기체.

    바이킹 로봇팔 미스터리의 주인공이 바로 이 엔지니어링 모델이다. 우주엔 간 적 없지만 설계는 실제 비행 모델과 똑같다. 역사적 가치는 오히려 더 크게 쳐주는 경우도 있다.

    NASA는 퇴역 장비를 어떻게 굴리나

    NASA는 임무 끝난 하드웨어를 크게 세 갈래로 나눠 처리한다. 역사적 가치가 큰 물건은 스미소니언 국립항공우주박물관 같은 곳에 정식 기증한다. 교육·홍보용으로 쓸 만하면 대학이나 과학관에 대여 형태로 넘긴다. 나머지는 창고에 묵혀두다가 예산이나 공간이 부족해지면 조용히 폐기하는 수순을 밟는다. 문제는 이 세 갈래 중 정확히 어디로 갔는지 기록이 안 남는 경우가 적지 않다는 거다. 1960~80년대 초창기 임무는 자산관리 규정 자체가 지금처럼 촘촘하지 않았다.

    사라진 유물, 결국 어디로 흘러가나

    공식 기록에서 빠졌다고 유물이 통째로 사라지는 건 아니다. 상당수는 은퇴한 엔지니어 차고, 계약업체 창고, 심지어 경매 시장으로 흘러 들어간다. 소더비(Sotheby’s) 같은 경매소에서 아폴로 시대 부품이 개인 소장품으로 낙찰되는 사례, 꾸준히 나온다. 우주 역사 연구자들이 낡은 사진이나 계약 문서, 참여 엔지니어의 증언까지 뒤지며 부품 하나의 행방을 쫓는 이유가 여기에 있다. 공식 아카이브만으로는 퍼즐이 안 맞춰진다.

    비슷한 사례들 — 잃어버렸다가 다시 나타난 것들

    이런 일, 처음이 아니다.

    • 아폴로 11호 달 착륙선 하강 엔진 일부는 수십 년간 행방불명이었다가 개인 수집가 창고에서 발견됐다.
    • 초기 머큐리 계획 우주복 시제품은 계약업체가 파산하는 와중에 자산 목록에서 통째로 빠졌다.
    • 제미니 계획 훈련용 캡슐은 한때 놀이공원 전시품으로 쓰이다가, 뒤늦게야 정체가 밝혀졌다.

    패턴은 비슷하다. 담당 기관이 사라지거나 조직이 개편될 때, 그리고 디지털화 이전 시대 문서일 때 유물의 행방이 끊길 확률이 확 높아진다.

    직접 확인해보고 싶다면

    우주 역사에 관심이 생겼다면 이렇게 확인해볼 수 있다.

    • 스미소니언 국립항공우주박물관 온라인 컬렉션에서 소장품 목록과 사진을 검색해본다.
    • NASA 이미지·비디오 라이브러리에서 임무 당시 찍힌 하드웨어 사진과 비교해본다.
    • 지역 과학관이나 대학 박물관에 걸린 우주 장비 명판을 유심히 읽어본다. 의외로 진짜 엔지니어링 모델인 경우가 많다.
    • 경매 기록 다루는 우주 수집품 전문 사이트에서 출처(provenance) 정보를 확인한다.

    부품 하나 이력을 추적하는 작업, 우주 탐사 자체만큼이나 손이 많이 간다. 그래도 그 과정에서 반세기 전 엔지니어들이 손으로 직접 조립했던 기계의 이야기가 다시 세상 밖으로 나온다는 점, 이건 확실히 매력적이다.

    출처: Ars Technica

  • AI한테 랜덤 숫자 물어보면 왜 맨날 7이 나올까

    AI한테 랜덤 숫자 물어보면 왜 맨날 7이 나올까

    챗봇 아무거나 켜서 “1부터 10 사이 숫자 하나만 말해줘”라고 쳐보자. 십중팔구, 7이다. “하나 더”라고 물으면 이번엔 3이나 4쯤 나오고, 그다음엔 8이나 9 언저리를 맴돈다. 사람한테 물어봐도 비슷한 쏠림이 생기긴 한다. 근데 진짜 문제는 따로 있다. ChatGPT든 클로드든 제미나이든, 브랜드를 안 가리고 거의 같은 숫자로 수렴한다는 거다. AI가 ‘무작위’라는 말을 근본적으로 오해하고 있는 셈인데, 이유를 알아두면 실무에서 AI 다루는 감각이 확 달라진다.

    AI는 애초에 주사위를 던지지 않는다

    대형언어모델, 그러니까 LLM은 다음에 올 단어(정확히는 토큰)를 확률 분포로 계산해서 뽑는 방식으로 돌아간다. “1부터 10 사이 숫자”라는 문장 뒤에 어떤 숫자가 나올 확률이 제일 높은지, 답은 이미 학습 데이터 안에 있다. 사람들이 인터넷에 “랜덤으로 숫자 하나 골라봐”라는 글을 남길 때 유독 7을 자주 썼고, 심리학 쪽 연구를 봐도 사람이 ‘진짜 무작위처럼 느껴지는’ 숫자로 7을 제일 많이 고른다는 결과가 있다. AI는 이 편향을 그대로 흡수해서 되풀이할 뿐이다. 결국 AI한테 무작위 숫자를 요구하는 건 동전을 던지라는 게 아니라, “사람들이 무작위라고 생각할 때 가장 많이 답한 숫자를 말해줘”라고 시키는 것과 다를 게 없다.

    온도(Temperature)라는 손잡이의 정체

    API 좀 만져본 사람이라면 temperature라는 파라미터, 한 번쯤 봤을 거다. 이게 바로 확률 분포에서 얼마나 과감하게 골라잡을지를 정하는 다이얼이다.

    • temperature가 0에 가까우면 가장 확률 높은 답만 골라서, 물어볼 때마다 거의 똑같은 결과가 나온다
    • 1 이상으로 올리면 확률 낮은 후보들도 뽑힐 틈이 생겨서 답이 다채로워진다
    • ChatGPT 웹이나 클로드 웹처럼 대부분의 챗봇 서비스는 이 값을 사용자가 직접 못 만지게 해놨다. 서비스 쪽에서 적당히 낮게 고정해둔 경우가 많다

    그래서 개발자용 API 콘솔이나 코드로 직접 호출할 때는 temperature를 1.0~1.3 사이로 올려보자. 답변이 다양해지는 게 바로 체감된다.

    여러 AI가 똑같이 획일화되는 진짜 문제

    숫자 하나 못 맞히는 거야 사실 별일 아니다. 진짜 골치 아픈 건 브레인스토밍, 아이디어 도출, 창작 작업에서도 비슷한 쏠림이 나타난다는 점이다. 회사 이름 지어달라, 소설 도입부 써달라, 마케팅 문구 뽑아달라 하면 — 서로 다른 회사 모델인데도 구조나 표현이 신기하리만치 겹친다. 학계에서는 이걸 모드 붕괴(mode collapse)라고 부른다. 사람 피드백으로 모델을 미세조정하는 RLHF 과정에서, 평가자들이 무난하고 안전한 답을 선호하다 보니 모델이 점점 ‘정답처럼 보이는 하나의 스타일’로 수렴해버리는 현상이다. 결과적으로 독립적으로 만들어진 모델들인데도 사고방식이 비슷해지는, 일종의 집단사고 상태에 빠지는 셈이다.

    진짜 무작위 값이 필요할 땐 이렇게

    추첨, 게임, 통계 시뮬레이션처럼 진짜 무작위성이 필요한 작업이라면, 챗봇한테 직접 묻는 것보다 다음 방법이 낫다.

    • 프로그래밍 언어의 난수 함수를 쓴다. 파이썬이면 random.randint(), 자바스크립트면 Math.random()
    • random.org처럼 대기 소음 기반으로 진짜 난수를 뽑아주는 서비스를 이용한다
    • AI한테 직접 답을 내라고 하지 말고, “파이썬 코드로 1~10 사이 난수를 뽑아서 실행해줘”처럼 코드 실행 기능으로 우회시킨다. 코드 실행 환경이 붙어 있는 도구라면 이 방식이 훨씬 믿을 만하다

    답변을 다채롭게 뽑아내는 프롬프트 팁

    창작이나 아이디어 작업에서 획일화를 피하고 싶으면 프롬프트 자체를 바꿔보는 것도 방법이다. “완전히 다른 3가지 관점에서 답해줘”, “기존과 겹치지 않는 답만 골라줘”, “일부러 덜 흔한 선택지를 제시해줘”처럼 다양성을 못 박아서 요구하면 결과가 확 달라진다. 같은 질문을 여러 AI 서비스에 동시에 던져서 답을 비교해보는 것도 획일화에서 벗어나는 실용적인 방법이다. 결국 AI 답변의 패턴을 한번 이해하고 나면, 언제 AI한테 맡기고 언제 진짜 난수 도구나 사람 판단을 더해야 하는지 감이 잡힌다. 이건 알아두면 두고두고 쓸 일이 많다.

    출처: MIT Tech Review AI

  • 아이클라우드 Hide My Email 뜻과 사용법, 이메일 가리기 기능 제대로 뜯어보기

    아이클라우드 Hide My Email 뜻과 사용법, 이메일 가리기 기능 제대로 뜯어보기

    아이폰으로 뭔가에 가입할 때 이메일 입력란 옆에 작게 뜨는 버튼 하나. ‘이메일 가리기’. 한 번쯤 눌러본 사람 많을 거다. 애플이 붙인 정식 이름은 Hide My Email이다. 진짜 지메일이나 회사 메일 주소를 내놓지 않고도 회원가입, 뉴스레터 구독, 온라인 쇼핑까지 다 할 수 있게 해주는 기능이다. 그런데 최근 이 기능에 보안 허점이 있다는 연구 결과가 나왔다. 그래서 이게 믿을 만한 기능인지 궁금해하는 사람이 늘었다. 개념부터 사용법, 실제로 어떤 위험이 있는지까지 하나씩 정리해본다.

    Hide My Email, 정확히 뭘 가려주는 기능일까

    Hide My Email은 애플이 iCloud+ 유료 구독자에게 주는 랜덤 이메일 생성 기능이다. 앱스토어에서 가입하거나 웹사이트에 이메일을 넣을 때, 진짜 주소 대신 [email protected] 같은 무작위 문자열 가짜 주소를 만들어준다. 이 가짜 주소로 온 메일은 애플 서버를 거쳐 실제 메일함(아이클라우드든 지메일이든)으로 자동 전달된다. 상대방은 진짜 주소를 모른다. 특정 서비스에서 스팸이 쏟아지기 시작하면? 그 가짜 주소 하나만 지우면 끝이다.

    작동 원리 – 진짜 주소는 어떻게 숨겨지나

    구조 자체는 단순하다. 애플이 중간에서 우편함 역할을 한다고 보면 된다.

    • 가입 시 생성된 임시 주소로 메일이 도착
    • 애플 서버가 발신자와 제목, 본문은 그대로 두고 수신 주소만 바꿔서 전달
    • 사용자는 실제 메일함에서 평소처럼 확인
    • 답장을 보내도 상대방에게는 여전히 임시 주소로 표시

    이 구조 덕분에 이론상으로는 어느 사이트에 가입해도 진짜 주소가 새 나갈 일이 없다. 문제는 ‘이론상’이라는 단서. 중계 서버를 거치는 과정에서 발신자 정보나 헤더 값이 제대로 가려지지 않으면, 기술적으로 진짜 주소를 거꾸로 추적할 여지가 생긴다. 실제로 보안 연구자들이 이런 허점을 찾아내 보고한 사례가 있었다. 그래서 마스킹 이메일을 100% 안전하다고 맹신해서는 안 된다는 지적이 나온다.

    설정하는 법 – 아이폰·맥에서 3분이면 끝

    아이폰 기준으로는 어렵지 않다.

    • 설정 → 본인 이름(Apple ID) → iCloud → Hide My Email 진입
    • ‘새로운 주소 만들기’를 눌러 라벨(어떤 서비스용인지)을 지정
    • 생성된 주소를 복사해 회원가입 이메일란에 붙여넣기
    • 사파리에서는 이메일 입력란을 탭하면 자동으로 ‘나의 이메일 가리기’ 제안이 뜬다

    메일 앱이나 설정에서 언제든 만든 주소 목록을 확인하고, 전달을 끄거나 아예 삭제할 수 있다. 이 기능은 iCloud+ 요금제(월 0.99달러부터) 가입자만 무제한으로 쓸 수 있다. 무료 계정은 애플 자체 서비스 가입 시에만 제한적으로 이용 가능하다.

    알아둬야 할 보안 리스크 3가지

    편리하다고 무조건 안전한 건 아니다. 실제로 체크해야 할 부분이 있다.

    • 헤더 정보 노출 가능성: 일부 이메일 클라이언트나 서버 설정에 따라 원본 헤더에 발신 경로가 남는 경우가 보고됐다. 민감한 가입에는 별도의 프라이버시 중심 메일 서비스를 같이 쓰는 게 안전하다.
    • 전달 지연 문제: 인증 시간에 민감한 경우 중계 과정에서 몇 초에서 몇 분씩 지연이 생기기도 한다.
    • 계정 종속성: 애플 계정 자체가 정지되거나 문제가 생기면 만들어둔 가짜 주소도 전부 같이 먹통이 된다. 핵심 계정 복구용 이메일로는 쓰지 않는 게 낫다.

    은행이나 정부 서비스처럼 신원 확인이 까다로운 곳에는 마스킹 이메일 대신 진짜 주소를 쓰는 편이 나중에 골치 아플 일이 적다. 이건 거의 원칙에 가깝다.

    Hide My Email vs 파이어폭스 릴레이 vs 덕덕고, 뭐가 다를까

    비슷한 서비스는 애플만 만든 게 아니다.

    • Firefox Relay: 무료로 5개 주소까지 생성 가능, 파이어폭스 계정만 있으면 OS 상관없이 사용
    • DuckDuckGo Email Protection: 트래커 제거 기능이 추가로 붙어 있어 마케팅 추적 차단에 강함
    • SimpleLogin·AnonAddy: 자체 도메인 연결, 답장 시 발신자 표시 커스터마이징 등 고급 기능 지원

    애플 Hide My Email의 강점은 iOS·맥과의 통합이다. 사파리에서 원클릭으로 생성되고 메일 앱에서 관리까지 한 번에 끝난다. 안드로이드나 윈도우를 같이 쓰는 사람에게는 크로스 플랫폼을 지원하는 Firefox Relay나 SimpleLogin이 더 편할 수도 있다.

    이런 상황이면 이렇게 써라

    모든 가입에 무조건 가짜 주소를 쓸 필요는 없다.

    • 한 번 쓰고 말 이벤트, 쿠폰 다운로드용 가입 → Hide My Email 적극 추천
    • 자주 쓰는 쇼핑몰, 커뮤니티 → 가짜 주소로 만들되 라벨을 명확히 남겨서 나중에 찾기 쉽게
    • 은행, 보험, 정부24 같은 신원 확인형 서비스 → 진짜 주소 사용
    • 업무용 뉴스레터 구독 → 회사 메일 노출이 부담스럽다면 마스킹 주소로 시작해도 무방

    핵심만 3줄 요약

    Hide My Email은 진짜 주소를 감춰주는 애플의 기능이다. 스팸 관리와 사생활 보호에 확실히 도움이 된다. 다만 최근 헤더 마스킹 허점이 보고된 사례에서 보듯 완전 무결점은 아니다. 그러니 은행·정부 서비스 같은 민감한 곳에는 쓰지 않는 게 안전하다. 결국 언제 어디에 쓸지 구분해서 활용하는 사람이 실속을 챙기는 셈이다.

    출처: TechCrunch

  • 노트북LM 사용법, 이제 60초 영상으로도 요약해준다

    노트북LM 사용법, 이제 60초 영상으로도 요약해준다

    구글 노트북LM에 자료를 올리면 60초짜리 세로형 영상으로 요약해주는 기능이 새로 생겼다. 논문이든 보고서든 통째로 읽기 부담스러울 때, 핵심만 짧은 클립으로 보고 넘어갈 수 있게 됐다. 이참에 노트북LM이 정확히 뭘 하는 도구이고 어떻게 써야 본전을 뽑는지 짚어본다.

    노트북LM, 정체가 뭐냐면

    노트북LM은 구글이 내놓은 AI 노트 정리 서비스다. PDF, 구글 문서, 웹페이지, 유튜브 링크 같은 자료를 올리면 그 내용만 학습해서 요약, 질문 답변, 오디오 팟캐스트, 마인드맵까지 만들어준다. 일반 챗봇과 다른 점 하나. 인터넷 지식을 끌어오지 않고 올린 자료 안에서만 답을 찾는다는 것이다. 그래서 출처가 분명하고, 환각(엉뚱한 정보를 지어내는 현상) 위험도 상대적으로 낮은 편이다.

    영상 요약 기능, 쓰는 법

    새로 추가된 영상 클립 기능, 순서는 이렇다.

    • 노트북LM에 자료(논문, 강의자료, 회의록 등)를 업로드한다
    • 좌측 메뉴에서 영상 요약(비디오 오버뷰) 옵션을 선택한다
    • AI가 핵심 내용을 뽑아 세로형 60초 클립으로 자동 생성한다
    • 완성된 영상을 다운로드하거나 바로 재생해서 확인한다

    틱톡이나 릴스 보듯 짧게 훑어보고 핵심만 챙기는 방식이다. 출퇴근길, 자투리 시간에 자료 따라잡기에 딱이다.

    어떤 자료를 올려야 결과가 잘 나오나

    구조가 명확한 자료일수록 요약 품질이 올라간다. 소제목으로 나뉜 보고서, 슬라이드 형태 강의자료, 타임스탬프 박힌 유튜브 강의 영상이 특히 잘 먹힌다. 반대로 손글씨 스캔본이나 표가 복잡하게 얽힌 문서는 인식률이 뚝 떨어진다. 가능하면 텍스트 추출이 잘 되는 PDF나 구글 문서로 바꿔서 올리는 게 결과물 차이를 만든다.

    무료로 어디까지 되나

    기본 기능은 구글 계정만 있으면 공짜다. 다만 영상 클립 같은 신기능은 AI Ultra, Pro 구독자부터 순차로 풀리는 구조라 무료 계정에는 아직 안 보일 수 있다. 업로드 가능한 소스 개수, 만들 수 있는 오디오·영상 분량도 요금제마다 다르다. 업무용으로 본격적으로 쓸 계획이면 구독 등급부터 확인하는 게 순서다.

    챗GPT, 노션AI랑 뭐가 다르냐면

    챗GPT는 범용 대화형 AI다. 인터넷 전반의 지식을 끌어다 답한다. 노션AI는 메모나 문서 작성을 돕는 쪽에 가깝다. 노트북LM은 결이 다르다. 업로드한 자료 기반의 리서치 도구라서다. 논문 여러 편을 비교 분석하거나, 회의록을 모아 패턴을 찾거나, 강의자료를 요약 정리하는 작업엔 노트북LM이 더 정확하다. 반대로 일반적인 글쓰기나 아이디어 브레인스토밍은 챗GPT 쪽이 강점을 보인다. 용도에 맞춰 섞어 쓰는 게 효율적이다.

    이럴 때 써먹기 좋다

    • 대학생: 수십 페이지짜리 논문을 빠르게 훑고 핵심 주장만 파악할 때
    • 직장인: 회의록이나 보고서를 팀원에게 공유하기 전 짧은 요약본을 만들 때
    • 콘텐츠 제작자: 자료 조사 단계에서 출처별 핵심 내용을 정리할 때
    • 수험생: 방대한 교재 내용을 오디오로 변환해 듣기 학습에 활용할 때

    자료를 통째로 던져놓고 필요한 부분만 골라 받는 방식이다. 정보량이 많을수록 시간 절약 효과는 커진다.

    헷갈리는 부분들, Q&A로 정리

    Q. 한국어 자료도 영상으로 요약되나?
    한국어 PDF나 문서도 업로드 가능하고, 요약 결과도 한국어로 나온다. 다만 기능 자체가 단계적으로 풀리는 중이라 지역이나 계정에 따라 노출 시점이 다를 수 있다.

    Q. 업로드한 자료, 외부로 새어 나가지는 않나?
    업로드한 소스는 해당 노트북 안에서만 쓰이고 다른 사용자 학습에는 쓰이지 않는다고 안내한다. 그래도 민감한 사내 문서를 다룰 땐 회사 보안 정책부터 한 번 확인하고 쓰는 게 안전하다.

    Q. 영상 클립 길이나 스타일, 바꿀 수 있나?
    지금은 60초 안팎의 정해진 포맷으로 자동 생성되는 구조다. 길이나 톤을 세밀하게 조절하는 옵션은 아직 별로 없다. 디테일한 커스터마이징이 필요하면 별도 영상 편집 도구와 같이 쓰는 편이 낫다.

    출처: The Verge

  • 싸고 빠른 VPN 고르는 법, 결국 이 세 가지로 갈린다

    싸고 빠른 VPN 고르는 법, 결국 이 세 가지로 갈린다

    한 달에 커피 한 잔 값도 안 되는 돈으로 인터넷 트래픽을 통째로 암호화해준다면, VPN 요금제 한 번쯤 다시 들여다볼 만하다. 막상 검색창에 ‘VPN’을 치면 비슷비슷한 이름의 서비스가 수십 개씩 쏟아진다. 가격도 들쭉날쭉. 뭘 기준으로 골라야 나중에 후회 안 할지, 차근차근 짚어본다.

    VPN이 실제로 해주는 일

    VPN은 내 기기와 서버 사이를 암호화된 터널로 묶어주는 도구다. 해외 OTT 우회용이라고만 생각하면 오산이다. 진짜 쓸모는 보안 쪽에 더 가깝다.

    • 공용 와이파이(카페, 공항, 호텔)에서 비밀번호·카드정보 가로채기 방지
    • 인터넷서비스제공업체(ISP)의 접속 기록 추적 차단
    • 실제 IP 주소를 가려 위치 기반 추적 회피
    • 해외 출장이나 여행 중 국내 서비스 접속

    기업이 쓰는 보안용 VPN과 개인이 매달 돈 내고 쓰는 상용 VPN은 목적부터 다르다. 이 글에서 다루는 건 후자, 그러니까 일반 소비자용 구독 서비스다.

    가격대로 나눠보면 등급이 보인다

    VPN 시장, 가격대별로 성격이 꽤 또렷하게 갈린다.

    • 무료형 — 광고가 붙거나 데이터가 제한된다. 일부는 사용자 데이터를 팔아서 운영비를 메우기도 하니, 믿을 만한 곳인지 따로 확인해야 한다
    • 저가형(연 3만~5만원대) — 기본 암호화에 적당한 서버 수, 동시접속 5~10대 수준. 비트디펜더 VPN처럼 가격으로 승부 보는 서비스들이 이 구간에 몰려 있다
    • 프리미엄형(연 10만원 이상) — 외부 감사까지 받은 노로그 정책, 멀티홉, 전용 IP, 광고·트래커 차단 같은 부가 기능이 붙는다

    저가형이라고 보안이 허술하다는 뜻은 아니다. AES-256, WireGuard 같은 핵심 암호화 표준은 가격과 상관없이 거의 똑같이 적용된다. 진짜 차이는 부가 기능이랑 서버 인프라 규모에서 갈린다.

    속도부터 느린 VPN, 미리 걸러내자

    VPN 켜면 속도 좀 떨어지는 건 어쩔 수 없는 일이다. 그런데 체감조차 안 될 정도로 빠른 서비스가 있는가 하면, 답답해서 못 쓰겠다 싶은 서비스도 분명 있다.

    • 프로토콜이 WireGuard를 지원하는지부터 확인 — 기존 OpenVPN보다 속도와 배터리 효율이 낫다
    • 접속하려는 국가에 서버가 충분한지, 서버 숫자보다 위치 분산이 더 중요하다
    • 가입 전 환불 보장 기간(보통 30일) 안에 화상회의·스트리밍으로 직접 테스트
    • 피크 시간대(저녁 8~10시) 속도 저하 정도, 후기에서 미리 확인

    속도는 광고 문구 말고 직접 trial로 재보는 게 제일 정확하다. 같은 회사 서버라도 지역마다 혼잡도 차이가 크다.

    노로그 정책, 말만 믿지 말 것

    거의 모든 VPN 업체가 “접속 기록 안 남긴다”고 광고한다. 문제는 이걸 검증할 길이 마땅치 않다는 점. 그래서 아래 세 가지는 따로 챙겨봐야 한다.

    • 제3자 보안 업체의 독립 감사를 받았는지 — 업체 자체 발표 말고 외부 검증
    • 본사가 어느 나라에 있는지. 미국·영국처럼 정보공유동맹(5아이즈, 9아이즈, 14아이즈)에 속한 국가는 법적으로 데이터 제출 요구를 받을 가능성이 상대적으로 높다
    • 과거 정부 기관에 데이터를 넘긴 적이 있는지, 압수수색 이력은 없는지 검색해보기

    파나마나 스위스처럼 데이터 보호법이 빡빡한 나라에 본사를 둔 업체들이 노로그 정책을 유독 강하게 내세우는 이유, 여기에 있다.

    킬스위치·멀티홉, 나한테 진짜 필요한가

    VPN 연결 끊기는 순간 인터넷 자체를 막아버리는 킬스위치, 서버 두 개 거쳐서 우회 경로를 두 겹으로 만드는 멀티홉. 듣기엔 다 매력적이다. 근데 이게 모두한테 필요한 기능은 아니다.

    • 일반적인 웹서핑·스트리밍 용도라면 킬스위치 정도로 충분하다
    • 언론인, 인권운동가, 민감한 정보를 다루는 직군이라면 멀티홉과 전용 IP까지 고려할 만하다
    • 광고·트래커 차단 기능은 호불호가 갈리니, 일단 무료 체험으로 써보고 판단하는 편이 낫다

    고급 기능이 붙을수록 가격은 올라가고 속도는 조금씩 손해를 본다. 본인 사용 패턴이랑 맞바꿀 가치가 있는지, 그 계산이 핵심이다.

    결국 따져볼 건 세 가지뿐

    가격, 속도, 노로그 검증. 이 순서대로만 확인해도 잘못 고를 확률은 크게 줄어든다.

    • 예산이 빠듯하면 저가형 + WireGuard 지원 여부부터 확인
    • 업무나 민감한 정보를 다룬다면 독립 감사받은 노로그 정책 업체로 후보를 좁히기
    • 구독 전엔 반드시 환불 기간 안에 실제 속도와 접속 안정성 테스트하기

    완벽한 VPN은 없다. 본인이 트래픽을 어디에 가장 많이 쓰는지, 스트리밍인지 재택근무인지 해외 결제인지부터 정리하면 후보군은 저절로 좁혀진다.

    관련 내용은 Wired 리뷰 기사를 참고했다.

  • 노화를 거꾸로 돌린다는 ‘세포 리프로그래밍’, 어디까지 왔나

    노화를 거꾸로 돌린다는 ‘세포 리프로그래밍’, 어디까지 왔나

    베조스가 노화를 멈추는 데 돈을 걸었다. 알트먼도 마찬가지다. 실리콘밸리 거물들이 수십억 달러를 쏟아붓는 분야, 공통분모를 따라가 보면 결국 하나의 기술로 모인다. 세포 리프로그래밍(cellular reprogramming)이다. 늙은 세포를 어렸을 때 상태로 되돌려서 노화 자체를 거꾸로 돌린다는 이야기, 한때는 SF 영화 소재였다. 지금은 실험실 단계까지 와 있다. 원리가 뭔지, 실제로 어디까지 진행됐는지 차근차근 정리해본다.

    세포 리프로그래밍, 정확히 뭘 하는 기술인가

    DNA 서열을 건드리는 게 아니다. 유전자는 그대로 두고, 그 위에 쌓인 화학적 표지(에피지넘)만 초기화하는 작업이다. 비유하자면 하드디스크 파일은 안 건드리고 설정값만 공장 초기화하는 셈. 세포는 나이가 들수록 어떤 유전자는 켜지고 어떤 유전자는 꺼지는 패턴이 쌓인다. 이 패턴을 다시 어린 세포 상태로 맞춰주면 세포의 ‘생물학적 나이’가 젊어진다는 게 핵심 가설이다.

    야마나카 인자, 노화를 되돌리는 단백질 4개

    출발점은 2006년, 일본 과학자 신야 야마나카의 연구다. 4가지 단백질 — Oct4, Sox2, Klf4, c-Myc — 을 피부세포에 주입했더니, 그 세포가 배아줄기세포처럼 뭐든 될 수 있는 상태로 돌아갔다. 이 4가지를 묶어서 야마나카 인자라 부른다. 이 발견으로 2012년 노벨 생리의학상도 받았다. 원래는 줄기세포를 만들기 위한 기술이었는데, 최근 연구는 방향이 좀 다르다. 인자들을 아주 짧게만 적용해서 세포 정체성은 유지하면서 나이만 되돌리는 쪽으로 옮겨갔다.

    부분 리프로그래밍 vs 완전 리프로그래밍

    여기서 길이 둘로 갈린다.

    • 완전 리프로그래밍: 세포를 끝까지 초기화해서 줄기세포로 만든다. 피부세포가 정체성을 잃고 무엇이든 될 수 있는 세포로 바뀐다. iPS세포를 만들 때 쓰는 방식인데, 몸속에서 직접 했다간 종양으로 이어질 위험이 크다.
    • 부분 리프로그래밍: 야마나카 인자를 짧게, 또는 약하게만 노출시킨다. 세포 정체성은 그대로 두고 노화 시계만 되돌리는 식이다. 피부세포는 여전히 피부세포다. 다만 더 어릴 때의 유전자 발현 패턴을 갖게 된다.

    요즘 투자가 몰리는 쪽은 거의 다 부분 리프로그래밍이다. 안전성 관리가 그나마 수월해서다.

    동물실험, 어디까지 와 있나

    동물실험 데이터는 생각보다 인상적이다.

    • 하버드 데이비드 싱클레어 연구팀은 2020년, 시신경이 손상된 늙은 쥐에게 부분 리프로그래밍을 적용해 시력을 일부 되살렸다.
    • 근육과 신장 조직에서 노화 관련 손상이 줄어들었다는 보고도 나왔다.
    • 일부 연구에서는 쥐의 평균 수명 자체가 늘어나기도 했다.

    전부 쥐 얘기다. 사람 몸에서도 똑같이 작동할지는 아직 아무도 증명 못 했다.

    발목 잡는 건 결국 암

    걸림돌은 c-Myc이다. 이 단백질, 대표적인 암 유발 유전자(종양유전자)로 꼽힌다. 야마나카 인자를 너무 오래, 너무 세게 쓰면 세포가 통제 안 되고 증식하면서 기형종 같은 종양이 생길 위험이 커진다. 실제로 일부 쥐 실험에서 리프로그래밍을 과하게 적용한 그룹에서 종양이 나온 사례도 보고됐다. 그래서 연구자들은 c-Myc을 빼거나 노출 시간을 정밀하게 조절하는 쪽으로 안전성을 확보하려 매달리는 중이다. 이 기술이 임상까지 가려면 ‘얼마나 효과적인가’보다 ‘얼마나 안전하게 끌 수 있는가’가 더 큰 숙제인 셈이다.

    돈은 이미 몰렸다, 누가 들어와 있나

    속도가 가파르다.

    • 알토스랩(Altos Labs): 제프 베조스 등이 초기에 30억 달러 규모로 투자해 출범시킨 회사. 부분 리프로그래밍 기반 치료제 개발에 집중한다.
    • 레트로 바이오사이언스(Retro Biosciences): 샘 알트먼이 투자한 곳. 세포 리프로그래밍과 자가포식(autophagy) 연구를 같이 진행한다.
    • 뉴림(NewLimit), 라이프 바이오사이언스(Life Biosciences) 등도 비슷한 방향으로 연구비를 끌어모으는 중이다.

    대부분 아직 동물실험이나 초기 세포 단계다. 사람 대상 정식 임상시험에 들어간 곳은 거의 없다.

    그래서, 내 몸에 적용되려면 뭐가 더 필요한가

    전문가들 시각은 대체로 비슷하다. 사람 대상 정식 치료제가 나오려면 최소 10년은 더 걸릴 거라는 쪽. 넘어야 할 장벽도 명확하다. 암 위험을 통제할 정밀한 투여 방식, 특정 조직에만 정확히 전달하는 기술, 장기간 안전성을 입증할 대규모 임상 데이터. 이 세 가지가 다 갖춰져야 한다. 그 사이에 ‘세포 리프로그래밍’이나 ‘에피지넘 역전’을 내세운 고가 건강관리 서비스나 보충제가 마케팅 용어로 먼저 등장할 가능성, 솔직히 꽤 높다. 사람 몸에서 검증된 효과가 아직 없는 만큼, 이런 상품을 만나면 학술 논문에 실린 임상 데이터가 있는지부터 확인하는 게 합리적이다.

    출처: MIT Tech Review AI

  • AI 에이전트란? 코딩부터 연구까지 어디까지 써먹을 수 있나

    AI 에이전트란? 코딩부터 연구까지 어디까지 써먹을 수 있나

    개발자들 모이는 자리에 가면 요즘 빠지지 않고 나오는 말이 있다. “코드는 AI한테 맡기고 나는 검토만 한다.” 농담처럼 들렸는데, 더는 아니다. 같은 흐름이 이제 실험실 쪽으로도 옮겨가는 중이다. 신약 후보 물질을 찾는 연구자가 문헌 조사부터 데이터 분석까지 AI에게 떠넘기는 풍경, 머지않아 보일 거다. 이 변화의 한복판에 ‘AI 에이전트’라는 개념이 있다. 코딩, 연구, 마케팅, 고객 응대까지 업무 전반으로 번지고 있는 이 기술이 정확히 뭔지, 일상 업무에 어떻게 끌어다 쓸 수 있는지 한번 짚어본다.

    AI 에이전트, 정체가 뭐길래

    AI 에이전트는 사람이 목표만 던져주면 알아서 작업을 쪼개고, 필요한 도구를 골라 쓰고, 결과를 점검하면서 끝까지 밀어붙이는 AI 시스템이다. 질문에 답하는 수준을 넘어 실제로 ‘일을 처리’한다는 게 핵심. 특징을 정리하면 이렇다.

    • 목표 지향적으로 여러 단계 작업을 스스로 계획하고 실행한다
    • 코드 실행, 검색, 파일 읽기·쓰기 같은 외부 도구를 직접 호출한다
    • 중간 결과를 스스로 확인하고 틀리면 다시 시도한다
    • 사람 개입 없이 긴 작업을 이어서 처리한다

    챗봇이랑은 뭐가 다른가

    챗봇은 질문 하나에 답 하나 내놓고 끝이다. 에이전트는 다르다. “이 버그 좀 고쳐줘” 한마디에 코드를 읽고, 원인을 찾고, 수정하고, 테스트까지 돌린 다음 결과를 보고한다. 사람이 매 단계마다 지시를 내릴 필요가 없다는 점, 이게 결정적이다. 챗봇이 대화 상대에 가깝다면, 에이전트는 업무를 통째로 맡길 수 있는 직원에 가까운 셈이다.

    코딩 쪽에서 먼저 자리 잡은 이유

    AI 에이전트가 가장 먼저, 가장 빠르게 퍼진 분야는 단연 소프트웨어 개발이다. 이유는 단순하다. 코딩은 결과를 코드 실행이나 테스트로 바로 확인할 수 있고, 작업 단위도 함수 하나, 버그 하나, 기능 하나로 비교적 명확하게 쪼개지기 때문. Claude Code 같은 코딩 에이전트는 전체 코드베이스를 읽고, 터미널 명령을 실행하고, 테스트를 돌려 통과 여부까지 확인하는 식으로 움직인다. 사람은 한 발 물러나 결과물만 검토하면 되는 구조다.

    이제는 연구실까지

    최근 눈에 띄는 흐름이 하나 있다. 이 에이전트 방식이 과학 연구 영역으로 넘어가고 있다는 것. 제약사 임원이나 바이오텍 창업자, 연구자를 대상으로 한 자리에서 과학 연구 전용 AI 에이전트가 소개된 사례도 나왔다. 논문 검토, 실험 설계, 데이터 분석처럼 절차가 정형화돼 있고 결과 검증이 가능한 작업이라면 코딩과 구조가 별반 다르지 않다. 반복적인 문헌 조사나 데이터 정리에 드는 시간을 줄여주는 방향으로 쓰이는 흐름, 점점 강해지고 있다.

    내 업무에 써보려면 어디서부터

    거창하게 시작할 필요 없다. 오히려 작은 단위부터 건드려보는 쪽이 실패 확률을 줄인다.

    • 규칙이 명확하고 반복적인 업무부터 골라본다 (이메일 분류, 데이터 정리, 보고서 초안 작성 등)
    • 결과를 사람이 빠르게 확인할 수 있는 작업을 우선한다
    • 전체 업무를 통째로 맡기지 말고 일부 단계만 시범 적용해본다
    • 접근 권한과 작업 범위는 처음부터 좁게 잡는다

    도입 전에 따져봐야 할 것들

    에이전트가 작업을 끝까지 알아서 처리한다는 건, 뒤집어 보면 오류도 끝까지 밀고 나갈 수 있다는 뜻이다. 사실과 다른 내용을 그럴듯하게 지어내는 환각 문제는 여전히 남아 있고, 결과물을 검토할 사람은 따로 필요하다. 민감한 데이터를 다루는 업무라면 접근 권한과 보안 설정부터 꼼꼼히 따져야 한다. 사용량에 따라 비용이 늘어나는 구조라, 파일럿 단계에서 비용 대비 효과를 미리 가늠해보는 편이 안전하다. 이건 좀 보수적으로 접근해도 손해 볼 거 없는 부분.

    궁금한 것들, 미리 정리해본다

    Q. AI 에이전트와 기존 RPA(업무 자동화 툴)는 뭐가 다른가?
    RPA는 정해진 규칙대로만 움직이는 매크로에 가깝다. 화면 구조 하나만 바뀌어도 바로 멈춘다. AI 에이전트는 상황을 판단해 방법을 바꿔가며 목표를 달성하려 한다. 유연성 차이가 크다.

    Q. 비전공자도 AI 에이전트를 쓸 수 있나?
    가능하다. 코딩 지식 없이도 자연어로 지시하고 결과물만 검토하는 식으로 쓰는 사람, 늘고 있다. 다만 결과를 판단할 최소한의 도메인 지식은 필요하다.

    Q. 회사 보안 정책상 도입이 걱정된다면?
    외부 서버로 데이터가 나가지 않는 사내망 전용 옵션이 있는지, 권한을 세밀하게 제한하는 기능을 제공하는 서비스인지부터 확인하는 게 첫걸음이다.

    출처: MIT Tech Review AI

  • 메신저 GIF 검색 안 될 때, 진짜 원인과 해결법 총정리

    메신저 GIF 검색 안 될 때, 진짜 원인과 해결법 총정리

    디스코드에서 짤 찾으려고 GIF 아이콘을 눌렀는데, 검색창이 먹통이었던 적 있을 거다. 키워드를 쳐도 결과는 안 뜨고 로딩 바퀴만 빙글빙글. 왓츠앱에서도, 블루스카이에서도 비슷한 증상이 보고됐다. 범인은 앱 자체가 아니다. 진짜 원인은 따로 있다 — GIF 검색을 떠받치는 백엔드 API.

    구글 산하 Tenor처럼 GIF 검색 엔진을 운영하는 업체가 API 정책을 바꾸거나 외부 제공을 끊어버리면, 거기에 빌붙어 쓰던 메신저·SNS 앱들의 GIF picker가 한꺼번에 멈춘다. 도미노처럼. 원인을 알면 해결은 의외로 빠르다.

    GIF 검색이 갑자기 안 되는 진짜 이유

    디스코드, 왓츠앱, 블루스카이, X. 이 네 곳 다 자체 GIF 데이터베이스를 만들지 않는다. 대신 Tenor나 GIPHY 같은 전문 업체의 API를 호출해서 검색 결과를 끌어오는 구조다. API 쪽에서 엔드포인트를 바꾸거나 서비스를 종료하면? 앱을 업데이트하기 전까진 검색창에 뭘 입력해도 결과가 안 나온다. 앱을 지웠다 다시 깔아도 소용없는 이유가 바로 여기 있다.

    • API 제공사가 엔드포인트를 변경한 경우
    • 앱이 아직 새 API로 마이그레이션을 마치지 못한 경우
    • 네트워크나 지역 차단으로 GIF 서버 접속 자체가 막힌 경우

    디스코드 GIF 검색, 이렇게 고친다

    디스코드는 메시지 입력창의 GIF 아이콘을 눌렀을 때 검색이 안 되는 사례가 종종 올라온다. 일단 앱부터 최신 버전으로 업데이트할 것. 그래도 안 풀리면 캐시를 지워본다 — 데스크톱 앱은 Ctrl+R로 새로고침하거나, 설정 > 고급 메뉴에서 캐시 클리어. 모바일이라면 휴대폰 설정의 앱 정보 화면에서 캐시 데이터를 지우는 쪽이 효과적이다. 이래도 검색 결과가 텅 비어 있다면? 백엔드 API 마이그레이션이 아직 안 끝났을 가능성이 크다. 며칠 뒤 업데이트를 다시 받아보는 게 가장 확실한 방법이다.

    왓츠앱·X·블루스카이는 조금씩 다르다

    왓츠앱은 채팅창 이모지 패널 옆 GIF 탭에서 검색을 제공하는데, 이것도 결국 외부 GIF API에 기댄 구조다. X(옛 트위터)는 미디어 업로드 버튼 옆 GIF 메뉴에서 카테고리 추천과 검색을 같이 보여준다. 그래서 API가 말썽일 때 추천 탭은 멀쩡하고 검색만 막히는 경우도 있다. 블루스카이는 GIF 검색을 붙인 지 비교적 얼마 안 됐다. 그래서인지 백엔드 전환에 따른 일시적 오류가 상대적으로 자주 보인다. 그래도 세 서비스 공통점은 하나, 앱 업데이트가 제일 빠른 해결책이라는 것.

    Tenor vs GIPHY, 뭐가 다른가

    Tenor는 2018년 구글이 인수한 GIF 검색 엔진이다. 안드로이드 키보드와 구글 검색에 꽤 깊숙이 박혀 있다. GIPHY는 메타(옛 페이스북)가 한때 사들였다가 반독점 규제에 걸려 도로 팔아치운 이력이 있는, 완전히 별개의 서비스다. 두 업체 다 외부 앱에 무료 API를 제공해왔지만 수익 구조나 운영 방침은 서로 다르다. 한쪽이 API 제공을 줄이면 거기 의존하던 앱들이 다른 쪽으로 옮겨가는 식의 연쇄반응이 생긴다. 요즘 GIF picker가 갑자기 낯설어 보인다면, 십중팔구 이 마이그레이션 과정 중이라고 보면 된다.

    그래도 안 풀린다면 시도해볼 것들

    • 앱을 완전히 종료하고 재실행하기
    • 스마트폰·PC 운영체제 자체 업데이트 확인하기
    • 와이파이와 모바일 데이터를 번갈아 켜서 네트워크 문제부터 배제하기
    • 웹 브라우저로 Tenor나 GIPHY 사이트에 직접 들어가 GIF를 찾은 뒤, 링크나 파일로 공유하기

    마지막 방법, 임시방편이긴 한데 급할 땐 의외로 쓸 만하다. 찾은 GIF의 URL을 복사해 채팅창에 붙여넣으면 대부분 메신저가 알아서 미리보기를 띄워준다.

    결국 살아남는 건 어느 쪽 API일까

    메신저 앱이 자체 GIF 인프라를 직접 구축하려면 비용이 만만치 않다. 그래서 외부 API에 기대는 구조는 한동안 안 바뀔 거다. 이번 같은 마이그레이션 이슈도 주기적으로 또 터질 가능성이 높다. 자주 쓰는 앱에서 GIF 검색이 막혔다면, 패치 노트나 커뮤니티 공지부터 확인하는 습관을 들이는 게 제일 빠른 대응이다. 검색창만 붙들고 있어 봐야 답은 안 나온다.

    원문 보도: The Verge