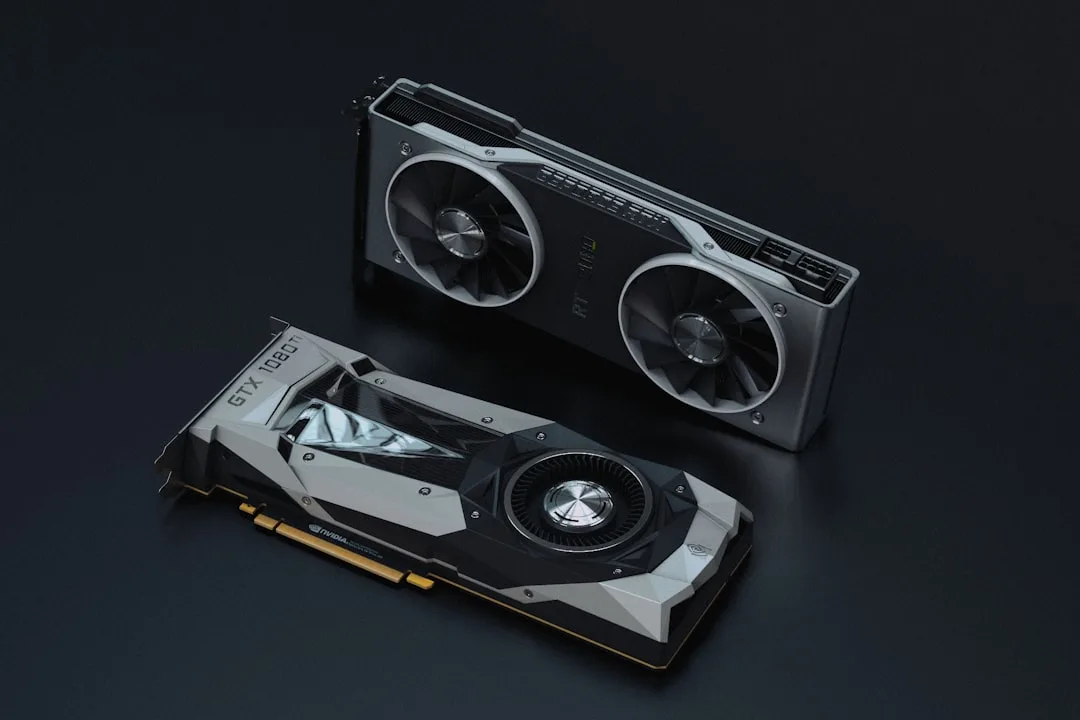
그래픽카드 견적 사이트부터 뒤진다. 거대 언어모델을 집 컴퓨터에서 돌려보겠다고 마음먹은 사람들 얘기다. 그런데 막상 부품을 맞춰보면 진짜 발목을 잡는 건 GPU 성능이 아니라 메모리 용량이다. 70B급 모델 하나 올리는 데만 수십 기가바이트 램이 필요한데, 일반 그래픽카드 VRAM은 12GB, 24GB에서 끊긴다. 여기서 대안으로 떠오른 게 통합 메모리를 쓰는 애플 실리콘 맥이다. 로컬 AI 개발자들 사이에서 요즘 은근히 자주 언급된다. 맥 스튜디오나 맥 미니로 로컬 AI 환경을 꾸리려는 사람을 위해 메모리 기준부터 사양 고르는 법, 여러 대 묶어 쓰는 방법까지 정리해봤다.
결국 메모리 싸움
언어모델은 파라미터 하나하나를 숫자로 저장해두고, 추론할 때마다 그 값을 전부 읽어들인다. 파라미터 70억 개(7B)짜리는 양자화를 거쳐도 최소 5~8GB가 필요하다. 700억 개(70B)짜리는 40GB 안팎. 일반 PC는 그래픽카드 VRAM과 시스템 램이 따로 논다. VRAM 용량 넘어서는 모델은 아예 못 올리거나, 속도가 뚝 떨어진다. 애플 실리콘은 다르다. CPU와 GPU가 메모리 풀 하나를 같이 쓰는 구조라서, 램만 넉넉히 달면 그 메모리를 GPU 연산에도 그대로 쓸 수 있다.
모델 크기별 램, 대략 이 정도
기준을 잡아두면 사양 고르기가 한결 쉽다.
- 7B~8B 모델: 16GB 램으로 양자화 버전 구동 가능. 챗봇, 코드 자동완성 수준
- 13B~14B 모델: 32GB 권장. 응답 품질과 속도 균형이 제일 좋은 구간
- 30B대 모델: 64GB부터 여유롭게 돌아간다
- 70B 모델: 96GB 이상. 실무에서 쓸 만한 속도를 원하면 128GB
- 100B~400B급 초대형 모델: 192GB~512GB. 사실상 맥 스튜디오 최상위 사양이거나, 여러 대를 묶어야 하는 영역
맥 스튜디오, 어디까지 올려야 하나
맥 스튜디오는 M4 맥스와 M3 울트라(혹은 이후 세대) 두 라인으로 나뉜다. 로컬 AI 용도라면 CPU 코어 수보다 램 용량과 메모리 대역폭을 먼저 봐야 한다. 개인 실험이나 사이드 프로젝트 수준이면 64GB 구성으로도 13B~30B 모델은 무리 없다. 70B급까지 노린다면 96GB 이상. 여러 모델을 동시에 띄워두고 비교하거나 파인튜닝 실험까지 하고 싶다면 128GB~256GB 구성을 권한다. 저장공간도 챙겨야 한다. 모델 파일 하나가 수십 기가바이트씩 나가기 때문에, 1TB보다는 2TB 이상 잡아두는 편이 나중에 후회가 적다.
맥 미니로도 될까
맥 미니는 M4 프로 기준 64GB까지 램 확장이 가능하다. 7B~30B급 모델을 다루는 입문자, 가벼운 로컬 챗봇 용도로는 충분하다. 가격 진입 장벽이 낮은 게 장점. 다만 70B 이상으로 넘어가는 순간 램 상한선에 바로 막힌다. 처음부터 큰 모델을 목표로 한다면 맥 미니보다 맥 스튜디오 하위 구성이 총소유비용 면에서 오히려 유리한 경우가 많다.
맥 여러 대 묶어서 더 큰 모델 돌리기
램 512GB, 1TB짜리 단일 머신은 가격이 만만치 않다. 그래서 개발자들 사이에서는 맥 스튜디오 여러 대를 썬더볼트로 연결해 하나의 큰 메모리 풀처럼 쓰는 방식이 퍼지고 있다. exo 같은 오픈소스 클러스터링 도구를 쓰면 모델 레이어를 여러 대에 나눠 분산 추론을 돌릴 수 있다. 맥 스튜디오 3~4대로 400B급 모델까지 굴리는 사례도 나온다. 애플이 최근 데스크톱 라인업을 개편하면서 이런 멀티 맥 구성을 염두에 둔 흔적이 뚜렷하다. 더 이상 소수 애호가만의 실험은 아니라는 얘기다. 다만 대역폭 한계 때문에 단일 대형 머신보다는 토큰 생성 속도가 떨어진다는 점은 감안해야 한다.
그래도 엔비디아가 유리한 상황은 있다
모든 상황에서 맥이 답은 아니다. 학습(트레이닝)이나 대규모 배치 추론처럼 순수 연산 속도가 승부를 가르는 작업이라면, CUDA 생태계와 압도적 연산 성능을 갖춘 엔비디아 GPU 쪽이 여전히 빠르다. 이미 파이토치·CUDA 기반 파이프라인을 구축해둔 팀, 여러 사용자 요청을 동시에 처리해야 하는 서버 환경이라면 그래픽카드 여러 장 꽂은 워크스테이션이나 클라우드 GPU 인스턴스가 더 맞다. 반대로 개인 개발자가 조용한 사무실 책상 위에서 전력 걱정 없이 큰 모델 켜놓고 실험하고 싶다면, 통합 메모리의 용량 이점이 속도 차이를 상쇄하고도 남는다. 솔직히 여기서 갈린다.
이것도 궁금하죠?
Q. 램만 많으면 무조건 큰 모델을 돌릴 수 있나?
메모리 용량이 충족돼도 대역폭이 낮으면 토큰이 느리게 나온다. 램 용량과 함께 메모리 대역폭 스펙도 같이 확인하는 편이 좋다.
Q. 로컬에서 모델을 돌리려면 어떤 소프트웨어가 필요한가?
Ollama, LM Studio 같은 도구를 쓰면 커맨드라인 지식 없이도 양자화된 모델을 몇 번의 클릭으로 내려받아 바로 실행할 수 있다.
Q. 클러스터링 구성이 초보자에게도 실용적인가?
네트워크 설정과 도구 설치 난이도가 있어서, 처음에는 단일 맥 스튜디오로 시작해 필요할 때 확장하는 쪽을 권한다.
출처: Ars Technica
테크가이드팀
Daily News Korea 테크가이드팀은 IT 기기 비교, 소프트웨어 추천, 트러블슈팅 가이드 등 실용적인 기술 콘텐츠를 제작합니다. 초보자도 쉽게 따라할 수 있는 단계별 가이드를 지향합니다.